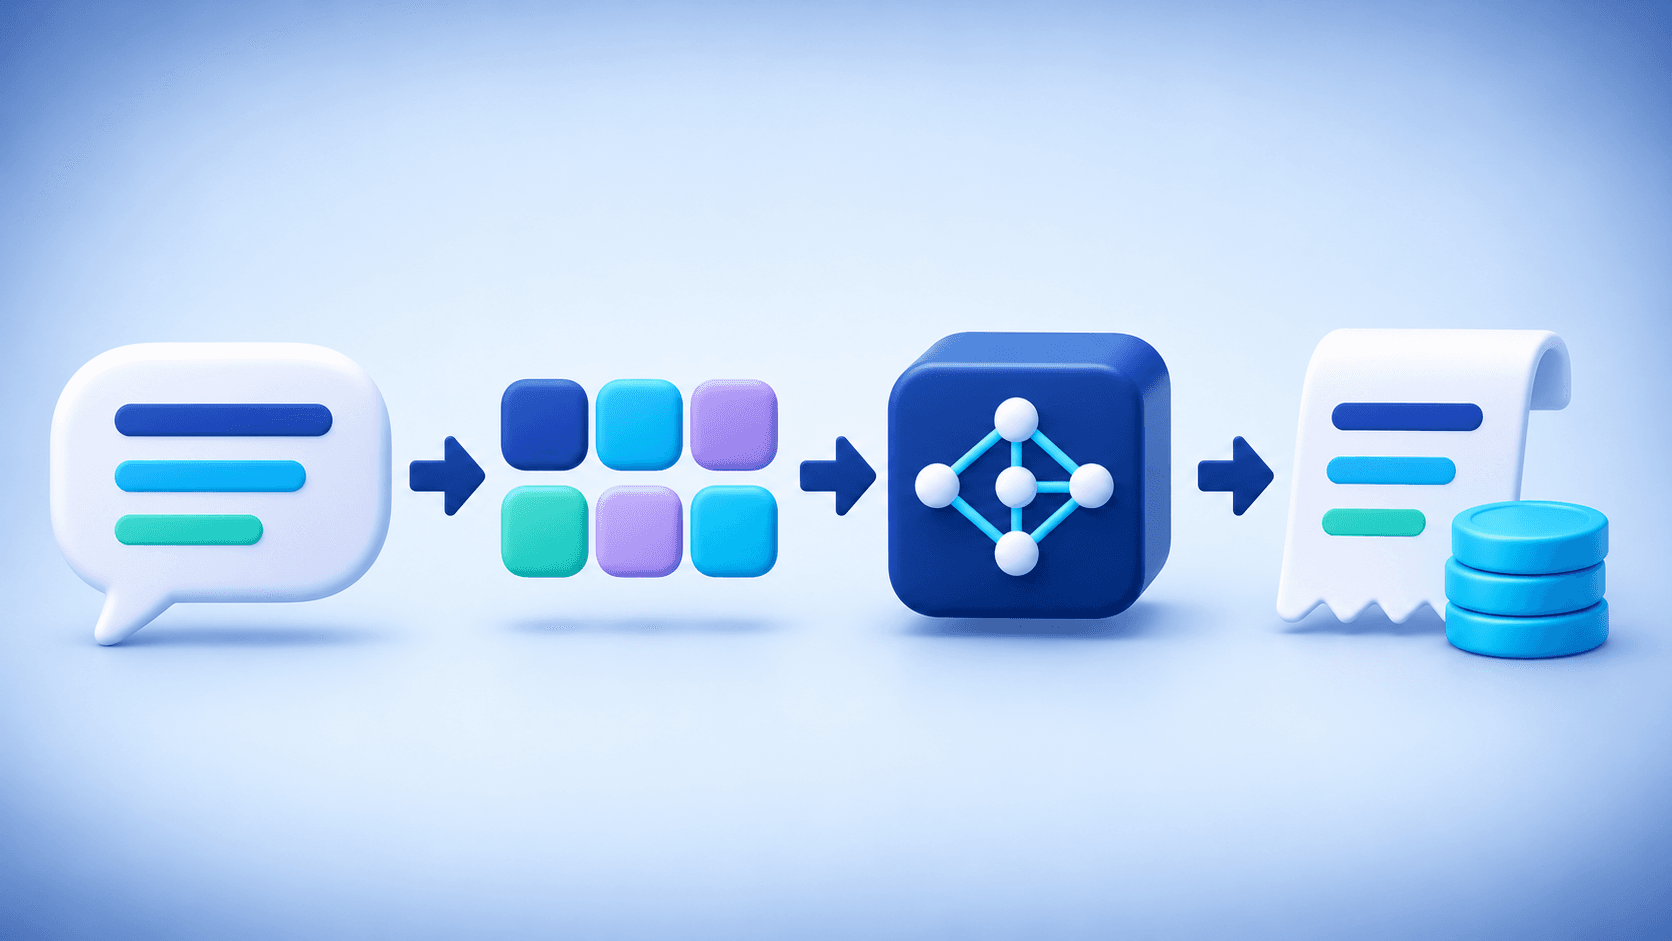
وقتی از یک مدل هوش مصنوعی سؤال میپرسید، هزینه معمولاً براساس تعداد «کلمهها» محاسبه نمیشود. مدل ابتدا متن را به قطعههای کوچکتری به نام توکن تقسیم میکند و سپس با پردازش همان توکنها پاسخ میسازد.
به همین دلیل، دو متن با تعداد کلمات یکسان میتوانند تعداد توکن متفاوتی داشته باشند. زبان متن، علائم نگارشی، عددها، کد برنامهنویسی و حتی مدل انتخابشده روی نحوه تقسیم متن اثر میگذارند. شناخت توکن کمک میکند بفهمید چرا یک گفتوگوی کوتاه ارزانتر است، چرا یک فایل طولانی هزینه بیشتری دارد و چگونه میتوان مصرف اعتبار را کنترل کرد.
توکن دقیقاً چیست؟
توکن کوچکترین واحدی است که مدل هنگام پردازش محتوا میبیند. یک توکن ممکن است یک کلمه کامل، بخشی از یک کلمه، یک علامت نگارشی، عدد یا چند نویسه باشد. بنابراین «یک توکن برابر یک کلمه» قانون درستی نیست.
تعداد توکنها به روش توکنسازی هر مدل و زبان متن بستگی دارد. متن فارسی و انگلیسی ممکن است با تعداد کلمه مشابه، مصرف یکسانی نداشته باشند. برای برآورد دقیقتر باید از شمارنده توکن همان سرویس یا مقدار usage در پاسخ API استفاده کرد.
توکن ورودی و خروجی چه تفاوتی دارند؟
توکن ورودی
هر چیزی که برای مدل فرستاده میشود بخشی از ورودی است: پرسش شما، دستورهای سیستمی، تاریخچه گفتوگو، متن فایلهای پیوست، اطلاعات بازیابیشده از منابع و گاهی نتیجه ابزارها. حتی اگر پیام جدید کوتاه باشد، یک گفتوگوی قدیمی و طولانی میتواند ورودی درخواست بعدی را بزرگ کند.
توکن خروجی
متنی که مدل تولید میکند خروجی است. پاسخ بلندتر معمولاً توکن خروجی بیشتری مصرف میکند. در بسیاری از مدلها نرخ توکن خروجی با ورودی برابر نیست و معمولاً گرانتر است، چون تولید مرحلهبهمرحله پاسخ به پردازش بیشتری نیاز دارد.
برخی سرویسها دستههای دیگری هم دارند: ورودی کششده، توکنهای استدلال، هزینه ابزارهایی مانند جستوجو و کدنویسی، یا هزینه جداگانه برای تصویر، صدا و ویدیو. بنابراین قبل از محاسبه باید صفحه قیمت همان مدل را بررسی کرد.
فرمول ساده محاسبه هزینه
هزینه ورودی = تعداد توکن ورودی ÷ یک میلیون × نرخ ورودی مدل
هزینه خروجی = تعداد توکن خروجی ÷ یک میلیون × نرخ خروجی مدل
هزینه نهایی = هزینه ورودی + هزینه خروجی + هزینه احتمالی ابزار یا رسانه
یک مثال ساده
فرض کنید یک مدل فرضی برای هر یک میلیون توکن ورودی ۱ واحد و برای هر یک میلیون توکن خروجی ۴ واحد دریافت کند. اگر درخواست شما ۱۰ هزار توکن ورودی و ۲ هزار توکن خروجی داشته باشد:
هزینه ورودی: ۱۰٬۰۰۰ ÷ ۱٬۰۰۰٬۰۰۰ × ۱ = ۰٫۰۱ واحد
هزینه خروجی: ۲٬۰۰۰ ÷ ۱٬۰۰۰٬۰۰۰ × ۴ = ۰٫۰۰۸ واحد
هزینه کل: ۰٫۰۱۸ واحد
این اعداد فقط برای توضیح فرمول هستند و قیمت واقعی هیچ مدل مشخصی نیستند. نرخها تغییر میکنند و باید همیشه قیمت روز سرویس بررسی شود.
چرا یک گفتوگوی طولانی گرانتر میشود؟
مدل برای حفظ پیوستگی مکالمه معمولاً بخشهایی از پیامهای قبلی را همراه درخواست جدید دریافت میکند. در نتیجه هرچه تاریخچه طولانیتر شود، ورودی درخواستهای بعدی نیز میتواند افزایش پیدا کند. اگر موضوع کاملاً عوض شده است، شروع یک گفتوگوی تازه مصرف اضافه را کاهش میدهد.
فایل، تصویر، صدا و ویدیو چگونه حساب میشوند؟
فایل متنی پس از استخراج محتوا به توکن تبدیل میشود. تصویر ممکن است با توجه به اندازه و جزئیات به واحدهای تصویری یا توکن تبدیل شود. صدا و ویدیو نیز ممکن است براساس مدت، کیفیت یا واحدهای مخصوص ارائهدهنده قیمتگذاری شوند. علاوه بر هزینه مدل، بعضی ابزارها هزینه جداگانه دارند.
پنجره زمینه با هزینه چه تفاوتی دارد؟
پنجره زمینه یا Context Window حداکثر ظرفیتی است که مدل میتواند در یک درخواست ببیند. این ظرفیت به معنای مصرف خودکار همه آن نیست. هزینه معمولاً براساس مقدار واقعی ورودی و خروجی محاسبه میشود، نه حداکثر ظرفیت مدل.
آیا تعیین سقف خروجی هزینه را کنترل میکند؟
بله، تعیین سقف مناسب میتواند جلوی پاسخهای بیش از حد طولانی را بگیرد؛ اما سقف، حداکثر مجاز است و نه مقدار قطعی مصرف. اگر مدل زودتر پاسخ را کامل کند، ممکن است توکن کمتری استفاده شود.
هفت راه برای کنترل هزینه بدون افت جدی کیفیت
۱. مدل را براساس نوع کار انتخاب کنید
برای خلاصهسازی ساده یا پاسخ کوتاه همیشه به قویترین و گرانترین مدل نیاز نیست. مدل پیشرفتهتر را برای کارهایی نگه دارید که واقعاً به استدلال، دقت یا زمینه بزرگ نیاز دارند.
۲. درخواست واضح بنویسید
هدف، قالب خروجی، محدودیتها و مخاطب را از ابتدا مشخص کنید. درخواست مبهم معمولاً باعث چند دور اصلاح و مصرف بیشتر میشود.
۳. برای موضوع جدید گفتوگوی تازه بسازید
اگر موضوع جدید ارتباطی با مکالمه قبلی ندارد، گفتوگوی تازه از ارسال تاریخچه غیرضروری جلوگیری میکند.
۴. فایل را قبل از ارسال مرتب کنید
صفحههای تکراری، ضمیمههای نامرتبط و متنهای اضافی را حذف کنید و فقط بخش لازم را بفرستید.
۵. طول پاسخ را مشخص کنید
مثلاً بنویسید «در پنج نکته» یا «حداکثر ۲۰۰ کلمه». این کار خروجی را کاربردیتر و قابل پیشبینیتر میکند.
۶. بازخوردها را یکجا جمع کنید
بهجای چند پیام کوتاه برای اصلاح، تغییرات موردنظر را یکباره و دقیق توضیح دهید.
۷. قیمت مدل را قبل از استفاده بررسی کنید
نام مشابه مدلها به معنای قیمت مشابه نیست. نرخ ورودی، خروجی، کش و ابزارها را در صفحه رسمی همان سرویس ببینید.
هویدای چگونه انتخاب را سادهتر میکند؟
در هویدای میتوانید مدلهای مختلف را در یک محیط مقایسه کنید. هنگام انتخاب فقط نام مدل را نبینید؛ کیفیت پاسخ فارسی، سرعت، ظرفیت زمینه، پشتیبانی از فایل و ابزار و نرخ مصرف هم مهماند.
برای کار روزمره، مدلی اقتصادی و سریع ممکن است بهترین انتخاب باشد. برای تحلیل پیچیده، کدنویسی حساس یا متن تخصصی، مدل قویتر میتواند ارزش هزینه بیشتر را داشته باشد. اطلاعات و قیمتهای نمایشدادهشده در پنل هویدای را مرجع روز در نظر بگیرید، زیرا نرخ ارائهدهندگان ممکن است تغییر کند.
جمعبندی
توکن پلی میان متن انسان و پردازش مدل هوش مصنوعی است. هزینه نهایی فقط به طول سؤال بستگی ندارد؛ ورودی، خروجی، تاریخچه مکالمه، فایلها، ابزارها و نوع مدل همگی اثرگذارند.
برای کنترل هزینه لازم نیست کیفیت را قربانی کنید. انتخاب مدل مناسب، نوشتن درخواست روشن، مدیریت تاریخچه و بررسی نرخ روز معمولاً بیشترین تأثیر را دارند.